

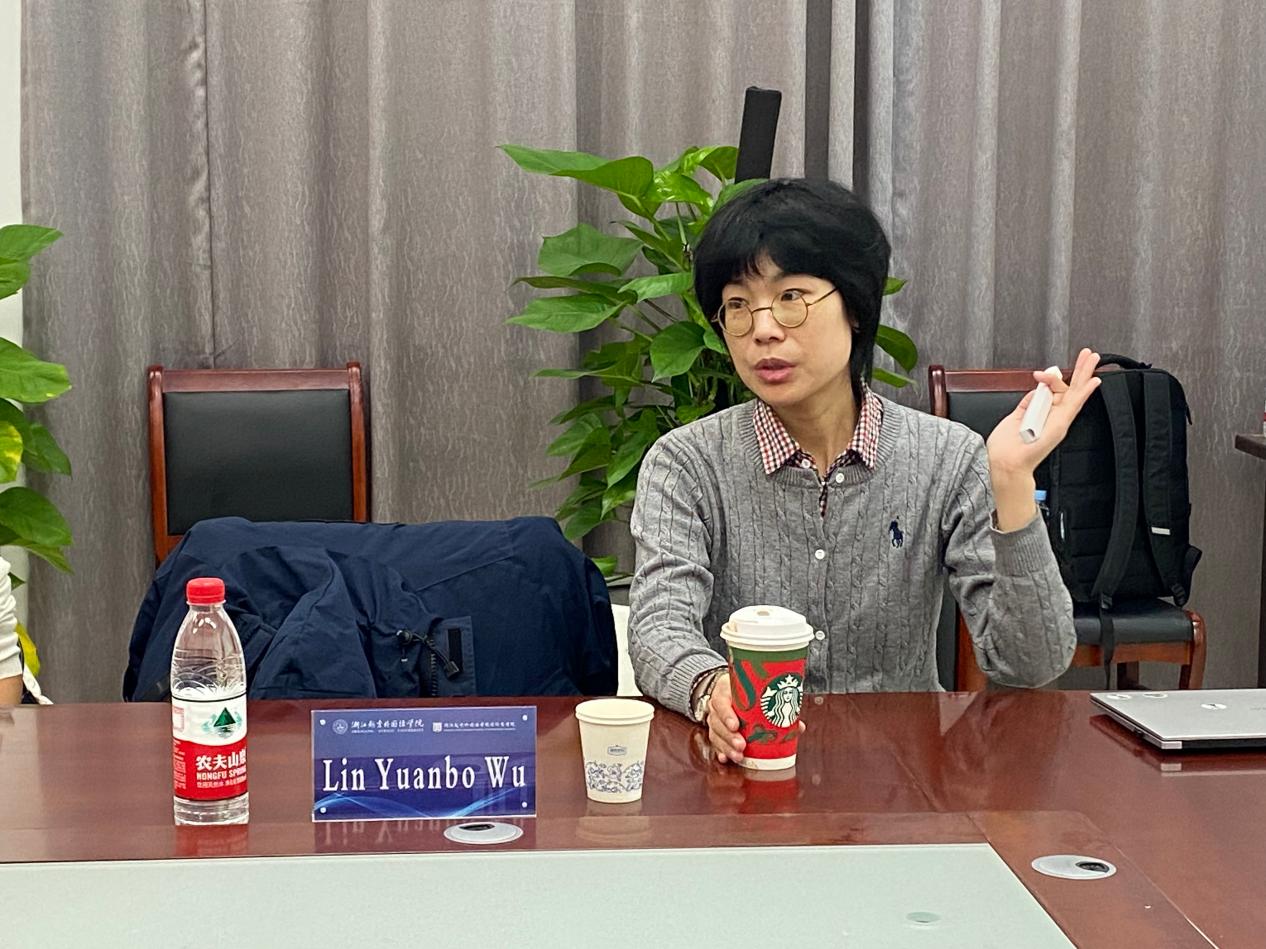
2026年10月8日,聚焦视觉语言模型前沿方向的专题讲座顺利举办。讲座由王佳桐副院长主持,武琳教授围绕“迈向空间智能与具身人工智能系统”作分享,并介绍了三项最新研究成果,在视频理解、可控人物图像动画生成、音视融合感知等方面取得技术提升。
针对视频目标识别分割场景,团队提出全新技术框架,能够依据自然语言描述,在动态视频中精准定位目标对象。该技术对文本信息进行拆解分析,结合视频内物体的运动轨迹完成追踪,再通过双重校验过滤错误识别结果。即便采用中小规模模型,依旧可以取得良好效果。依托物体间的空间位置关系,有效降低外观相似物体带来的识别干扰。
在可控人物图像动画生成方面,以往人工智能生成人物画面时,容易出现人物姿态、空间位置不符合现实物理逻辑的问题。该研究融入三维场景深度信息,实现了实现了人物运动轨迹与相机镜头运动的统一对齐,依靠几何约束优化生成效果,让人物姿态、站位更加符合现实逻辑,人物动作与镜头变化衔接更为自然,相关技术可应用于机器人学习等实际场景。
面向移动端等轻量化设备,团队研发高效的视听分割技术。传统视听感知算法计算开销大,难以在便携设备上流畅运行。新框架将视觉、音频信息分别处理,以音频信号引导视觉模块锁定声源对象,在大幅降低计算开销的同时,维持较高的识别准确度,便于在手机等终端设备部署使用。
讲座互动环节,师生围绕多模态学习、空间智能、具身智能的应用场景等问题踊跃提问,武琳教授逐一细致解答,现场交流气氛热烈。通过本次讲座,对视觉语言模型的前沿进展有了更直观的认识,也对人工智能如何理解物理世界、服务机器人学习等方向有了更深入的思考。讲座不仅拓宽了学术视野,也为后续科研选题和跨学科合作提供了有益启发。
图文:阮梦绮
一审:周晓丽
三审:李晓明